
はじめに
まずは、動画をご覧ください。
生成AIブームがここ数年急激に発展してきているわけですが、生成AIを個人が利用する場合は、ネットワークを通じてクラウドを使うしかないだろうと最初は見ていましたが、
最近はそれをMac mini上のローカルLLMで行おうとする人も増えています。これは、かつて流行した「自宅Webサーバー」を思い起こさせます。しかし「自宅Webサーバー」ブームは短命でした。というのは、機器のメンテナンスやウイルス感染、災害リスクが重くのしかかって個人が自宅で抱えていくのにはちょっと無理な発想だったわけです。
ローカルとクラウドの長所短所を考え合わせれば、やはりハイブリッド化していくのが合理的に思えてきますね。
私の場合ですが、今のところはクラウドだけを使っています。どの大手のAIにも移行できるように、ソースはtxtファイルをベースにして言語はPythonなどの一般的な言語を中心にしています。現在は成り行き上、Googleを使っています。Googleは何でも揃うのでラクと言うことでしょうか。Notebook・Gemini・Google AI Studioを連携させています。これらをうまく活用するための3つのポイントについて、大手IT企業のアプローチとの対比を交えながら解説します。
ポイント1:Gemini Notebookに「知識」を蓄える
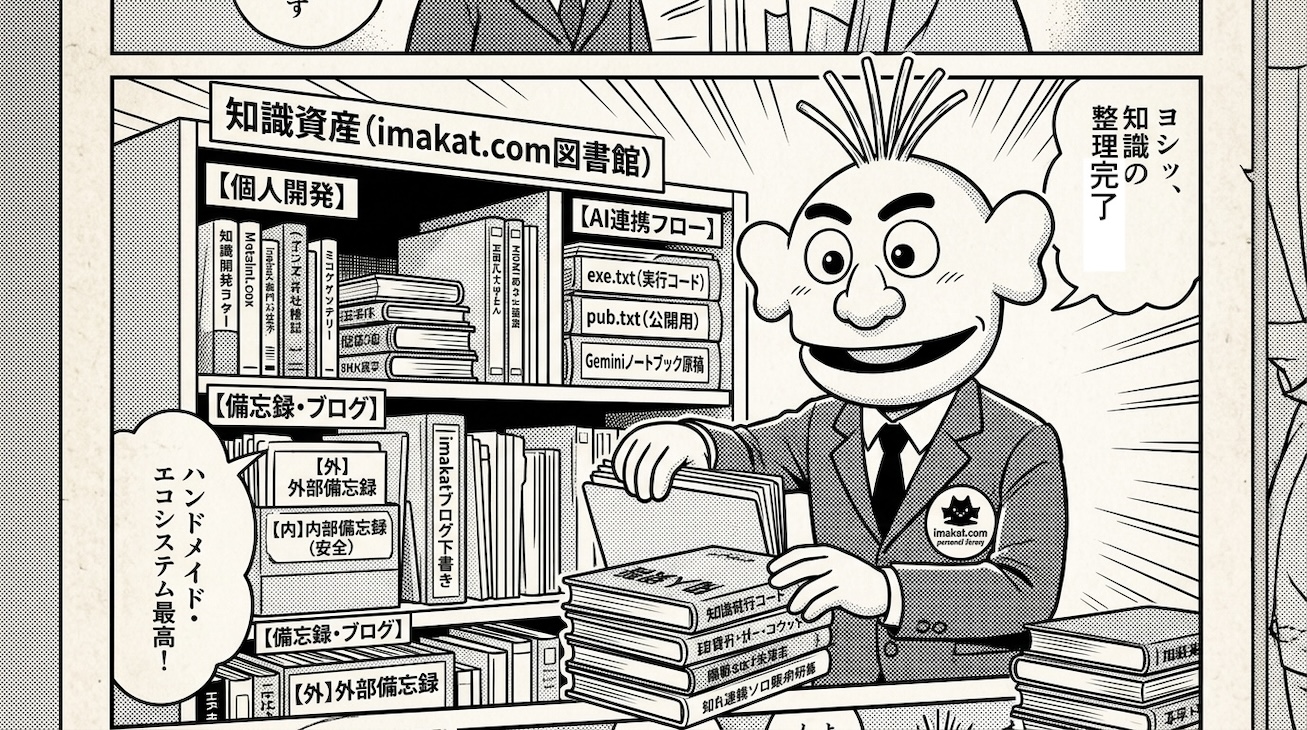
AIを開発パートナーとして機能させるための第一歩は、例えばNotebookへ前提知識(コンテキスト)を溜め込むことだと思います。溜め込みを判断するのはあくまで私です。生成AIに勝手に任せることはしません。やっぱり自分が中身を知っていることは重要ですから。私が生成AIによるコーディングを実行できたのも、imakatブログへの投稿の蓄積、自前でネットから拾い上げながらコツコツ作ってきたプログラムコードの蓄積、その他もろもろ、それらを知識ソースとして投入できたことが非常に大きいです。
古臭いと感じるかもしれませんが、年月かけてブログ投稿を積み重ねるのが役に立つと思います。SNSは瞬間の出来事の切り取りと感じた印象だけを記録するので知見の蓄積としてはちょっと弱い、やっぱりブログがいいと思います。始めるのは若ければ若いほどいいと思います。身近な改善や経験を備忘録のつもりで書いていく、記事の投稿の目標は、ばらつきはあるとしても月1点以上がいいと思います。大事な事は職業上の秘密には絶対に触れないことです。私としてはこのWordPressのブログをコツコツと続けてきて本当によかったと感じています。
Notebookを用途に合わせて明確に区分し、知識資産を分類・配置します。
大手IT企業と個人ハンドメイドの対比
| 比較項目 | 大手IT企業の通常アプローチ | 本エコシステムのハンドメイド手法 |
| 知識ソースの基盤 | 社内Wiki(Confluence等)や全社ポータルを専任チームが運用・保守 | Notebookの用途別「図書館」(自分用/公開用)に直接集約 |
| コンテキスト管理 | ベクターDBや高額な社内RAGシステムをインフラ構築して検索 | ノートブックのソース投入機能を活用し、追加費用ゼロで即時参照 |
| 情報区分の統制 | 複雑なアクセス権限(ACL)と閲覧ロール設定によるアクセス制限 | exe.txt(実行用)/pub.txt(公開用)/内外備忘録の命名規則でシンプルに統制 |
具体的な運用設計
- 目的別に「図書館」を分ける
- 自分用imakat図書館:日々の開発・ブログ記事執筆、メンテナンス・デバッグを行うためのプライベートな知識ベース。
- 公開用imakat図書館:外部共有、ブログ記事発信、公開向けのオープンな知恵袋。
- ソース(ファイル)の厳格な区分ルール
- 実行用コード(exe.txt):手元で実際に動作するコード。自分用図書館にのみ格納し、公開用には一切含めません。
- 公開用コード(pub.txt):後述のソフト秘匿化(サニタイズ)を施したコード。両方の図書館で共有します。
- imakatブログ(公開).txt:オープンな技術ノウハウや趣味雑学他の発信記事。両方の図書館に配置します。
- 外部備忘録.txt(※重要):
- 内部備忘録【内】:個人情報や個人的な日記など、外部秘にしたい記録(AI・Notebookには一切連携しない)。今後、セキュリティに強いAppleのAIに含めることになると思います。
- 外部備忘録【外】:作業記録、試行錯誤のチャットログ、技術アイデアなど。知識や経験の蓄積として自分用図書館にリンクさせ、AIの頭脳を育てます。
ポイント2:ハード秘匿化するモジュールを組み込む
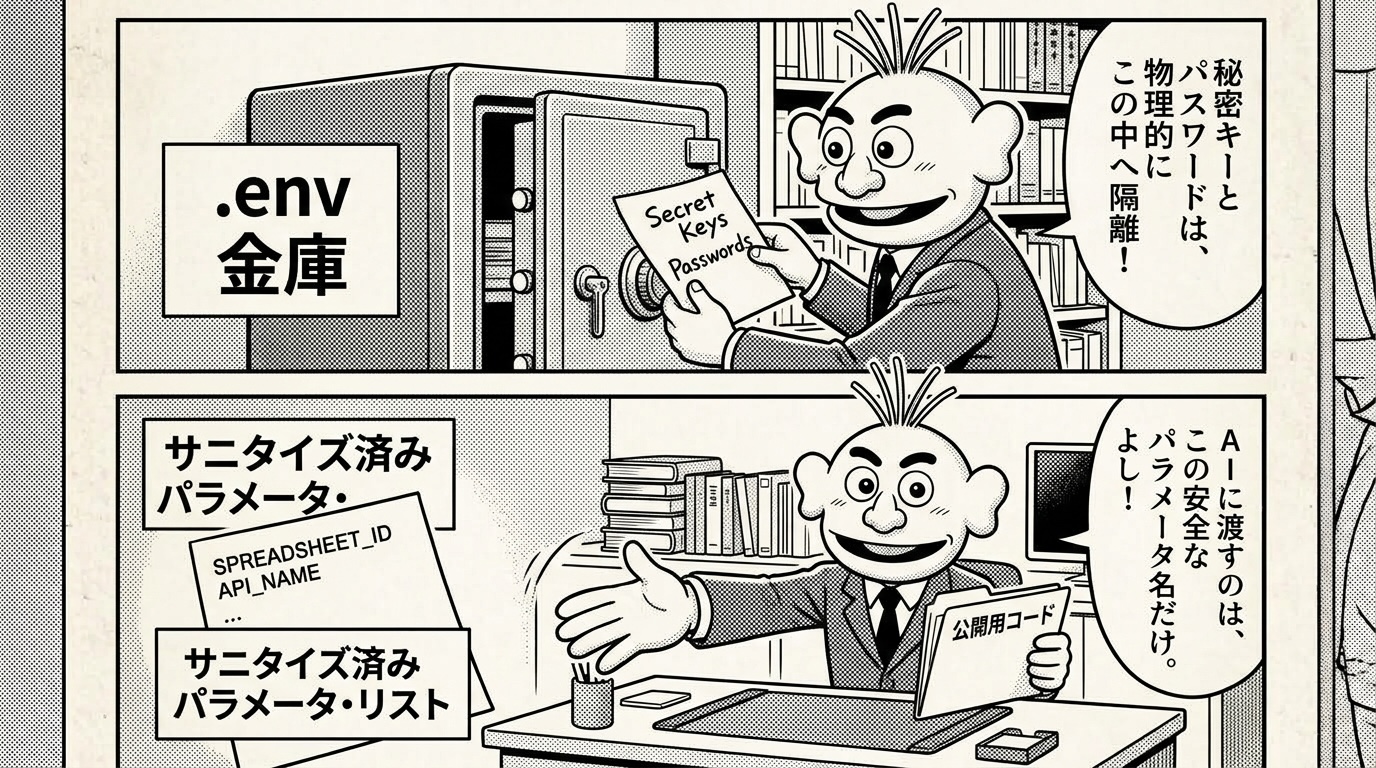
クラウド型生成AIにコードを渡す際、最も恐ろしいのが認証情報や特定ファイルIDの漏洩です。これを防ぐため、「二層秘匿化」を行いました。ただし、この秘匿化の登録もAIに任せるのではなく私が判断します。
大手IT企業と個人ハンドメイドの対比
| 比較項目 | 大手IT企業の通常アプローチ | 本エコシステムのハンドメイド手法 |
| 機密情報の保管 | クラウド金庫サービス(AWS Secrets Manager, HashiCorp Vault等)を有料導入 | ローカルの .env ファイルに隔離し、外部アクセスを物理遮断 |
| パラメータの払い出し | 専任のセキュリティ基盤がトークンを動的発行・認可管理 | Notebookを管理塔とし、プロンプト指示でパラメータのみをAIに持ち帰らせる |
| プライバシー対策 | リポジトリ監視ツール(GitGuardian等)によるコミット自動遮断 | ソフト秘匿化ルールにより、公開用コード生成時に固有名詞を自動サニタイズ |
具体的な運用設計
- 第1層:ハード秘匿化(実質的セキュリティ)
スプレッドシートIDやAPIキーをコード内に直接ベタ書き(SPREADSHEET_F8_ID = “1_ABCDabcd…”)せず、ローカルの .env ファイルへ隔離します。コード側は、Pythonの場合、 os.getenv(“SPREADSHEET_F8_ID”) で環境変数から動的ロードする構成を標準化します。 - ハード秘匿化モジュールはNoteBookで一元管理
生成AIのカスタム指示に「プログラムを作成している最中に、秘匿情報の設定が必要になったら、NoteBookへ行って秘匿情報にパラメータを設定してもらってパラメータだけを持ち帰って来ること。」と設定しておきます。AIに直接生データを触らせず、Notebookが安全なパラメータ名だけをコード側に橋渡しします。 - 第2層:ソフト秘匿化(見た目・見栄えの安全性)
メールアドレスや氏名などの固有名詞は、認証突破に直結しなくてもコードに残ると不格好で不用心です。公開用コード(pub.txt)を出力する段階で、これらの文字列を安全にマスキングします。
ポイント3:エラー修正プロセスを確実に実行する
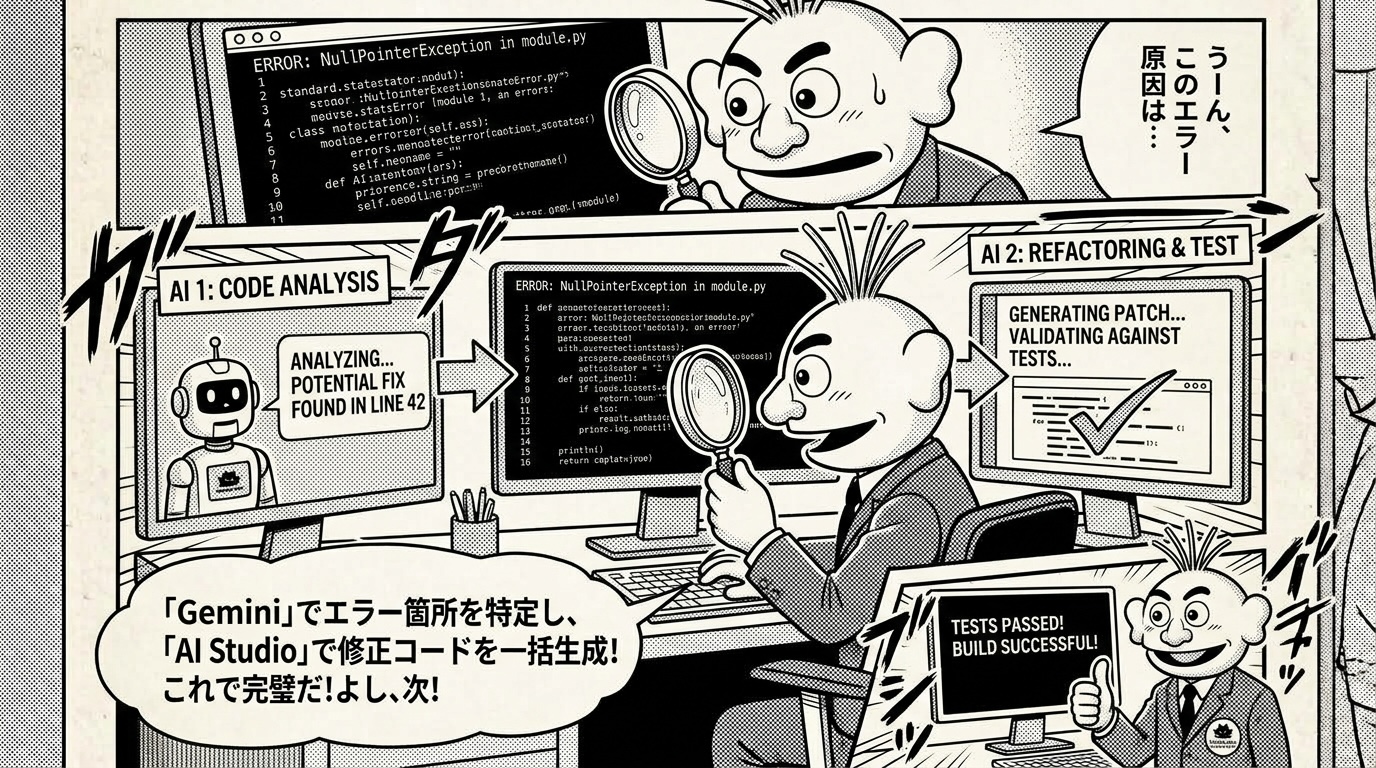
実は、エラーへの対処が一番難しいところです。2つの問題があります。一つは、時間が経つと、記憶も薄れ、このエラーはどのプログラムが関係していたのか思い出せなくなることです。突然のエラーは焦りまくるので尚更です。もう一つは、NoteBookが画像動画の解析能力がほとんどないことです。従って、エラー時につきものの、エラーのスクショはGeminiに解析してもらうことが入り口になります。ここは将来はNoteBookにその解析能力がつくことを期待するものですが。そうした得手不得手のある中で、強みを活かした連携フローを敷いてみました。
大手IT企業と個人ハンドメイドの対比
| 比較項目 | 大手IT企業の通常アプローチ | 本エコシステムのハンドメイド手法 |
| 障害受付(一次切り分け) | 運用監視ツール(Datadog等)+ヘルプデスク/一次運用オペレーター | Geminiによる画像解析(エラー画面のスクショを投げるだけで即座に言語化) |
| 原因特定・影響調査 | 構成管理DB(CMDB)の突合+熟練アーキテクトによる設計書レビュー | Notebookによる全コード台帳の横断検索+修正指示書の自動起票 |
| 修正・リファクタリング | 大規模リファクタリング専門チームによる設計・テスト・実装作業 | Google AI Studioの広大なコンテキスト長を活かした一括修正 |
具体的な運用設計
- 新規開発・改善のフロー
- NoteBookに相談:まずは知識が蓄積されているNoteBookで過去資産や影響範囲を照合。
- 規模に応じた切り分け:軽微な内容はNoteBook内で完結。400行を超える大規模ロジックや複雑な構造刷新は、広大なコンテキスト長を持つ Google AI Studio へ引き継いで一気に生成します。
- 秘匿化連携:コード生成の途中でキーやIDが必要になったら、常に横の「NoteBook(ハード秘匿化モジュール)」へ依頼してパラメータを取得します。
- エラー修正のリレー
- Geminiにエラー画像を投入(一次受付・言語化):画面スクショをGeminiに渡すだけで、根本原因や関連キーワードを正確にテキスト化(短い修正ならそのままGeminiで修正完了)。
- NoteBookに投げてファイル特定&指示書作成(司令塔):言語化されたキーワードをもとにNoteBookが全コード(exe.txt等)を横断検索し、「該当ファイルの特定」と「AI Studio用の修正指示書」を出力。
- AI Studioで修正・完結(確実な実行):指示書をAI Studioに流し込み、長文コードの整合性を保ったまま確実に修正を完了。
まとめ
さて、今回は、クラウド型生成AIについてその核心を3つのポイントにまとめたわけですが、こうやって記事を書いていても、まだなお、モヤモヤしているのは、3番目の、エラー処理のところです。Geminiに画像解析をさせてNotebookに引き継いでコードを抽出する、というところです。ここを一つにまとめたいのです。そこで、「画像解析からコード抽出」の部分を、ローカルLLMで処理することに挑戦してみたいと思います。その後で、コードが大規模の場合AI Studioへ引き継ぐのは、これはもう仕方ない事だと思います。だからハイブリッド型になりますね。
ただし挑戦するにしても、私にとって生成AIを含めたデジタル関係の趣味に掛けられるお金は月3000円くらいまでです。YouTubeを見ていると、3社以上の生成AIを契約して月10万円以上かけているような、おそらく本職がデジタル関係の方がたくさんいらっしゃるわけですが、私は生活費の一部から出費するわけですので、身の丈に合ったサービスを利用することになります。
改めて感じることですが、大企業から学ぶ真似ることは面白いと感じます。AIに聞けば、大企業がどのように諸課題を乗り越えているか解説してくれます。それを参考にして、それを小さくして簡単にして自分で作り込む。そのプロセスは結構未知な世界でワクワクするところです。そんなマインドが、個人開発を破綻させず、安全な長期利用につながっていくものと考えます。